Sorting 알고리즘은 크게 Comparisons 방식과 Non-Comparisons 방식으로 나눌 수 있다.
🧷 Comparisons 방식 알고리즘
Bubble Sort, Selection Sort, Insertion Sort, Quick Sort, Merge Sort, Heap Sort
🧷 Non-Comparisons 방식 알고리즘
Counting Sort, Radix Sort
Stable sort : 중복된 키를 순서대로 정렬하는 정렬 방식이다. 즉, 값이 같은 원소가 있어도 정렬 시 그 순서를 보장하는 방식이다.
In-place sort : 원소들의 개수에 비해 충분히 무시할만한, 거의 추가적인 메모리 공간을 사용하지 않는 정렬 방식이다.
🧷 거품 정렬 (Bubble Sort)
서로 인접한 두 원소의 대소를 비교하고, 조건에 맞지 않다면 자리를 교환하며 정렬하는 알고리즘이다.
-
각 회전마다, 첫 번째 원소와 두 번째 원소를 비교하고, 두 번째 원소와 세 번째 원소를 비교하고 교체하는 방식으로 전체 배열을 한 번 순회한다.
- 1회전의 결과로 가장 큰 값이 맨 뒤로 이동한다.
- 다음 회전부터는 맨 끝 원소는 제외하고 이를 반복한다.
void bubbleSort(int[] numbers) {
  int tmp = 0;
  for (int i = 0; i < numbers.length; i++) {
    for (int j = 1; j < numbers.length - i; j++) {
      if (numbers[j - 1] > numbers[j]) {
        tmp = numbers[j - 1];
        numbers[j - 1] = numbers[j];
        numbers[j] = tmp;
      }
    }
  }
}
🪚 장점
- 간단한 구현과 직관적인 코드
- In-place sort
- Stable sort
🪚 단점
- 정렬되어 있던, 안되어 있던, 2개의 원소를 비교하기 때문에 최선, 평균, 최악의 경우 모두 시간 복잡도가 으로 동일하다.
- 교환이 많이 발생한다.
| Time Complexity | Space Complexity |
|---|---|
❓
>=연산을 수행한다면 unstable 할까?
- 그렇지 않을까?
개선을 위해서는 어떻게 해야 하는가?
- 비교를 수행하지 않은 회전이 있다면 바로 정렬을 종료!
- 정렬 범위를 계속 업데이트하는 방식
- 양방향 버블 정렬
🪚 양방향 버블 정렬
정렬 범위를 계속 업데이트하는 개선 방식에 패스의 스캔 방향을 교대로 바꾸는 방식을 더한다. 이를 통해 점점 스캔하는 범위가 줄어들게 된다.
void cocktailSort(int[] numbers) {
  int left = 0;
  int right = numbers.length - 1;
  int last = right;

  while(left < right) {
    int i;
    int tmp = 0;

    // 가장 작은 원소가 맨 앞에 위치!
    for (i = right; i > left; i--) {
      if (numbers[i - 1] > numbers[i]) {
        tmp = numbers[i - 1];
        numbers[i - 1] = numbers[i];
        numbers[i] = tmp;
        last = i;
      }
    }
    // 마지막으로 교환이 일어난 위치
    left = last;

    // 가장 큰 원소가 맨 뒤에 위치
    for (i = left; i < right; i++) {
      if (numbers[i] > numbers[i + 1]) {
        tmp = numbers[i + 1];
        numbers[i + 1] = numbers[i];
        numbers[i] = tmp;
        last = i;
      }
    }
    // 마지막으로 교환이 일어난 위치
    right = last;
  }
}
🧷 선택 정렬 (Selection Sort)
버블 정렬과 유사한 알고리즘으로, 해당 회전에 원소를 넣을 위치는 이미 정해져 있고, 어떤 원소를 넣을지 선택하는 알고리즘이다.
- 각 회전마다, 배열에서 최솟값을 찾는다.
- 그 값을 맨 앞에 위치한 원소와 교체한다.
- 이후 회전부터는 맨 앞 원소를 제외하고 반복한다.
Insertion sort와 다른 점은, 배열에서 해당 자리를 선택하고, 그 자리에 올 값을 배열에서 선택하여 위치시키는 방식이다.
void selectionSort(int[] numbers) {
  int tmp = 0;
  for (int i = 0; i < numbers.length - 1; i++) {
    // 정렬될 원소를 넣을 위치 지정, 왼쪽에서부터 차례대로 수행
    int minIndex = i;
    // 최소값을 가지는 인덱스 탐색
    for (int j = i + 1; j < numbers.length; j++) {
      if (numbers[j] < numbers[minIndex])
        minIndex = j;
    }
    tmp = numbers[minIndex];
    numbers[minIndex] = numbers[i];
    numbers[i] = tmp;
  }
}
🪚 장점
- 간단한 구현
- 정렬을 위한 비교 횟수는 많지만, 버블 정렬에 비해 실제로 교환하는 횟수는 적다.
- In-place sort
🪚 단점
- 매 회전마다, 정렬된 원소를 제외하고 모든 원소에 대해 비교를 수행해야 한다. 최선, 평균, 최악의 경우 모두 시간 복잡도가 으로 동일하다.
- Unstable sort
| Time Complexity | Space Complexity |
|---|---|
❓
stable하게 하는 방법은?
- 최솟값과의 교환이 아닌, 나머지 원소들을 한 자리씩 뒤로 미는 방식으로 stable하게 할 수 있다.
🧷 삽입 정렬 (Insertion Sort)
선택 정렬과 유사하지만, 좀 더 효율적인 방식이다. i 번째를 정렬할 순서라고 가정하면, 0 부터 i - 1 번째 원소들은 정렬되어있다는 가정하에, i 번째 원소와 i - 1 번째 원소부터 0 번째 원소까지 비교하면서 큰 경우에만 교환한다.
- 2번째 위치의 값을
tmp에 저장한다. (1번째 원소는 정렬되었다고 가정) -
tmp와 이전에 있는 원소들과 비교하며 삽입해나간다. 이전의 원소들보다tmp에 있는 값이 작은 경우 교환한다.- 한 회전이 끝나고 나면,
tmp애 있는 값을 위치시킨다.
- 한 회전이 끝나고 나면,
- 다음 위치의 값(2번째 이후)을
tmp에 저장하고 이를 반복한다.
void insertionSort(int[] numbers) {
  for (int i = 1; i < numbers.length; i++) {
    int tmp = numbers[i];
    int prev = i - 1;
    // 이전 위치까지의 원소들 중 현재 삽입할 값보다 작은 값이 나올 떄까지 인덱스를 옮김
    while(prev >= 0 && numbers[prev] > tmp) {
      numbers[prev + 1] = numbers[prev];
      prev--;
    }
    numbers[prev + 1] = tmp;
  }
}
🪚 장점
- 단순한 알고리즘
- 대부분의 원소가 이미 정렬된 상태라면, 매우 효율적일 수 있다.
- In-place sort
- Stable sort
- 최선의 경우(모두 정렬된 경우, 1번씩만 비교를 수행) 의 시간 복잡도를 가지기에, 선택 정렬이나 버블 정렬보다는 상대적으로 빠르다.
- Online 알고리즘
Online alg : 시작하는 시점에 모든 정보를 가지고 있지 않고, 입력을 차례로 받으면서 처리하는 알고리즘
🪚 단점
- 평균과 최악의 시간복잡도가 이다.
- 배열의 길이가 길어질수록 비효율적이다.
선택 정렬과의 비교
- k번째 반복 이후, 첫 번째 k 요소가 정렬된 순서로 온다는 점에서 유사하지만, 선택 정렬은 k + 1번째 요소를 찾기 위해 나머지 모든 요소를 탐색해야 한다.
- 삽입 정렬이 더 효율적인 이유이다.
| Time Complexity | Space Complexity |
|---|---|
🧷 퀵 정렬 (Quick Sort)
분할 정복을 통해 주어진 배열을 정렬하는 방식이다.
- 배열 가운데서 하나의 원소를 선택한다. (Pivot이라 칭한다.)
-
피봇 앞에는 피봇보다 값이 작은 모든 원소들이 위치하고, 피봇 뒤에는 피봇보다 값이 큰 모든 원소들이 위치하도록 피봇을 기준으로 배열을 둘로 분할한다.
- 분할을 마친 뒤 피봇은 더 이상 움직이지 않는다.
- 분할된 두 개의 작은 배열에 대해 재귀적으로 위 과정을 반복한다.
분할 정복(Divide & Conquer) : 문제를 작은 2개의 겹치지 않는 문제로 분리하여 각각을 해결한 다음, 결과를 모아서 원래의 문제를 해결하는 전략
// 부분 배열을 정렬한다. 부분 배열의 크기가 충분히 작지 않은 경우 순환 호출하여 분할 정복한다.
void quickSort(int[] numbers, int left, int right) {
  if (left >= right) return;

  int pivot = partition(numbers, left, right);

  quickSort(numbers, left, pivot - 1);
  quickSort(numbers, pivot, right);
}

// 배열을 피봇 기준으로 비균등하게 2개의 부분 배열로 분할한다.
int partition(int[] numbers, int left, int right) {
  int pivot = numbers[left];
  int i = left, j = right;
  int tmp = 0;

  while(i < j) {
    while(pivot < numbers[j]) j--;
    while(i < j && pivot >= numbers[i]) i++;
    tmp = numbers[i];
    numbers[i] = numbers[j];
    numbers[j] = tmp;
  }
  numbers[left] = numbers[i];
  numbers[i] = pivot;

  return i;
}
🪚 개선
partition() 함수에서 피봇 값이 최소나 최대값으로 지정되어 부분 배열로 나눠지지 않았을 때, 의 시간 복잡도를 가진다.
- 즉, 이미 배열이 정렬된 경우 최악의 시간 복잡도를 가진다.
- 배열에서 가장 앞에 있는 값과 중간값을 교환해준다면, 시간 복잡도를 으로 개선할 수 있다.(최악의 시간 복잡도가 되는 것은 아님!)
🪚 장점
- 최선의 경우(매 피봇이 정확하게 두 부분 배열로 분할하는 경우), 시간 복잡도가 이다. (각 순환 호출 단계의 비교 연산은
N번, 총 비교 횟수는logN번) - 불필요한 데이터의 이동을 줄이고, 먼 거리의 데이터를 교환할 뿐만 아니라, 한 번 결정된 피봇들이 추후 연산에서 제외되는 특성으로, 시간 복잡도가 인 알고리즘 중 가장 빠른 정렬 알고리즘이다.
- In-place sort
🪚 단점
- 최악의 경우(이미 배열이 정렬된 경우), 시간 복잡도가 이다.
- Unstable sort
| Time Complexity | Space Complexity |
|---|---|
Java의
Arrays.sort()는 내부적으로 Dual Pivot Quick Sort를 사용한다.
- 삽입 정렬과 퀵 정렬을 합친 개념이다.
- 말 그대로 피봇을 2개 사용하고, 총 3개의 구역으로 분할하여 정렬한다.
🧷 병합 정렬 (Merge Sort)
합병 정렬이라고도 하며, 이 또한 분할 정복 알고리즘을 사용한다.
- 영역을 쪼갤 수 있을 만큼 쪼갠 후, 합병시키면서 정렬해나간다.
void mergeSort(int[] numbers, int left, int right) {
  if (left < right) {
    int mid = (left + right) / 2;

    // mergeSort()를 재귀적으로 계속 호출함으로써, 쪼개질 때까지 계속 쪼갬
    mergeSort(numbers, left, mid);
    mergeSort(numbers, mid + 1, right);
    merge(numbers, left, mid, right);
  }
}

// 정렬된 두 부분 배열을 순차적으로 비교하면서 병합
void merge(int[] numbers, int left, int mid, int right) {
  int[] L = Arrays.copyOfRange(numbers, left, mid + 1);
  int[] R = Arrays.copyOfRange(numbers, mid + 1, right + 1);

  int i = 0, j = 0, k = left;
  int lenL = L.length, lenR = R.length;

  while(i < lenL && j < lenR) {
    if (L[i] <= R[j]) numbers[k] = L[i++];
    else numbers[k] = R[j++];
    k++;
  }

  while(i < lenL) numbers[k++] = L[i++];
  while(j < lenR) numbers[k++] = R[j++];
}
순차적인 비교를 통해 정렬을 수행하기 때문에
LinkedList의 정렬이 필요할 때 효율적이다.
- 퀵 정렬은 임의 접근이기 때문에
LinkedList에 대해서는 성능이 좋지 않다.
퀵 정렬과 병합 정렬의 차이점
- 퀵 정렬: 우선 피봇을 통해 정렬한 후 영역을 쪼갬
- 병합 정렬: 영역을 쪼갤 수 있을 만큼 쪼갠 후 정렬
🪚 장점
- 최선, 최악, 평균의 경우 모두 시간 복잡도가 이다.
- Stable sort
🪚 단점
-
추가적인 메모리 공간이 더 필요하다.
- In-place sort이 아니다.
LinkedList를 사용하면 In-place 하게 할 수 있다.
| Time Complexity | Space Complexity |
|---|---|
🧷 힙 정렬 (Heap Sort)
완전 이진 트리를 기반으로 하는 힙을(Binary Heap) 기반으로 하는 정렬 방식
-
Binary Heap을 활용한 정렬 방식은 2가지가 있다.- 정렬 대상인 데이터들을 힙에 넣었다가, 꺼내는 원리로 정렬 (inplace sort X)
- 기존 배열을
heapify(heap으로 만드는 과정)을 거쳐 꺼내는 원리로 정렬 (inplace sort O)
- 최대 힙을 구성한다.
- 즉, 현재 힙의 루트에는 최댓값이 존재하게 된다. 루트의 값을 마지막 노드와 바꾼 후, 힙 사이즈를 1 줄인다.
- 힙의 사이즈가 1보다 큰 경우에 대해 위 과정을 반복한다.
- 매 과정마다 최댓값을 맨 뒤에 위치시키면서 정렬한다.
완전 이진 트리? : 삽입할 때 왼쪽부터 차례대로 추가하는 이진 트리로, 마지막 레벨을 제외한 모든 레벨은 채워져 있어야 한다.
최대 힙, 최소 힙
- 최대 힙 : 각 노드의 값이 해당
children의 값보다 크거나 같은 완전 이진 트리- 최소 힙 : 각 노드의 값이 해당
children의 값보다 작거나 같은 완전 이진 트리
void heapSort(int[] array) {
  int n = array.length;

  // 최대 힙 구성
  for (int i = n / 2 - 1; i >= 0; i--)
    heapify(array, n, i);

  // 최대 값 추출 후, 다시 최대 힙 구성 반복
  for (int i = n - 1; i > 0; i--) {
    swap(array, 0, i);
    heapify(array, i, 0);
  }
}

void heapify(int[] array, int n, int i) {
  int p = i;
  // 부모 노드 기준으로, 왼쪽 자식 노드와 오른쪽 자식 노드 idx 지정
  int l = i * 2 + 1;
  int r = i * 2 + 2;

  // 왼쪽 자식노드
  if (l < n && array[p] < array[l])
    p = l;

  // 오른쪽 자식노드
  if (r < n && array[p] < array[r])
    p = r;

  // 부모노드 < 자식노드
  if(i != p) {
    swap(array, p, i);
    heapify(array, n, p);
  }
}
🪚 장점
-
최선, 최악, 평균의 경우 모두 시간 복잡도가 이다.
heap에 데이터를 저장하는 시간 복잡도:heap에서 데이터를 삭제하는 시간 복잡도:
-
가장 크거나 가장 작은 값을 구할 때, 최대 k 만큼 떨어진 요소들을 정렬할 때 활용한다면 효율적이다.
- 최소 힙 or 최대 힙의 루트 값이기 때문에 한 번의 힙 구성을 통해 구하는 것이 가능하고, 삽입 정렬보다 더욱 개선된 결과를 얻어낼 수 있기 때문이다.
🪚 단점
- Unstable sort
- 데이터의 상태에 따라 같은 시간 복잡도를 가지는 다른 정렬 알고리즘에 비해 느리다.
| Time Complexity | Space Complexity |
|---|---|
아래 2가지의 정렬 알고리즘은 비교를 수행하지 않는
non-Comparisons Sorting Algorithm이다.
🧷 기수 정렬 (Radix Sort)
데이터를 구성하는 기본 요소(기수: Radix)를 이용하는 정렬 방식
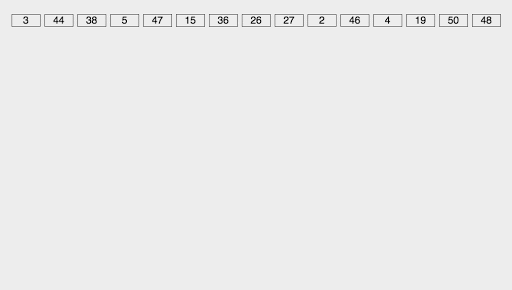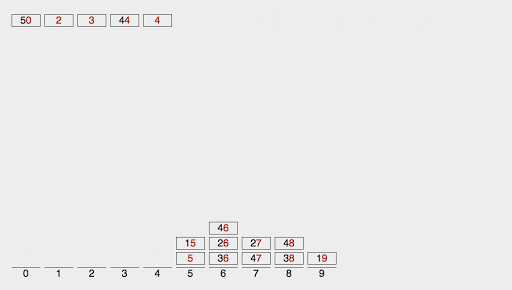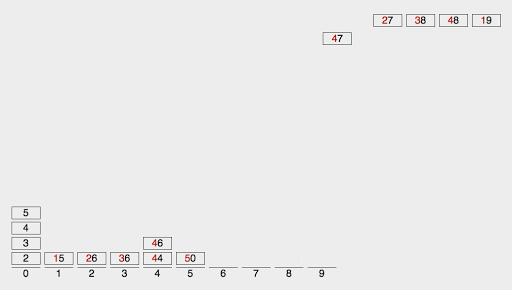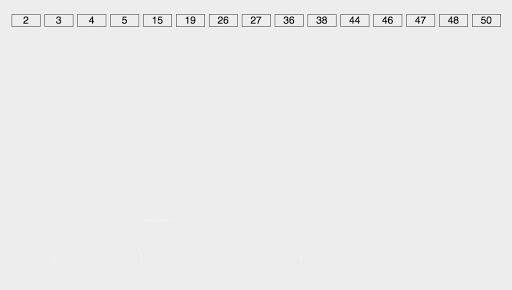
- 낮은 자릿수부터 비교하여 하나의 버킷을 생성해 분류하고, 그 다음 자릿수를 기준으로 이를 반복한다.
-
LSD(Least Significant Digit) 방식과 MSD(Most Significant Digit) 방식이 있다.
- LSD 방식은 덜 중요한 숫자부터 정렬하는 방식으로, 일의 자리부터 정렬한다.
- MSD 방식은 중요한 숫자부터 정렬하는 방식으로, 가장 큰 자릿수부터 정렬한다.
❓ 낮은 자릿수부터 정렬하는 이유 (MSD와 LSD의 비교)
- LSD는 중간에 정렬 결과를 볼 수 없다. 일의 자리부터 백의 자리까지 정렬을 마친 후 결과를 알 수 있다.
MSD는 중간에 정렬 결과를 확인할 수 있다. 따라서 정렬하는데 걸리는 시간을 단축시킬 수 있다.
- 하지만 이때, 정렬이 완료되었는지 확인하는 과정이 필요하고, 이때 메모리를 더 사용하게 된다.
결론적으로, LSD가 MSD보다 더 일관된 알고리즘이므로, 대개 기수 정렬을 논할 때는 LSD를 논한다.
입력 데이터의 최댓값에 따라 정렬하는
Counting Sort의 비효율성을 개선하기 위해 사용 가능하다.
- 자릿수의 값 별로 정렬을 하기에 나올 수 있는 값의 최대 사이즈는 0 ~ 9(10)이다.
void radixSort(int[] arr, int n) {
  // 최댓값 찾기
  int m = Arrays.stream(arr).max().getAsInt();

  // 최댓값을 나눴을 때, 0이 나오면 모든 숫자가 exp의 아래
  for (int exp = 1; m / exp > 0; exp *= 10)
    countSort(arr, n, exp);
}

void countSort(int[] arr, int n, int exp) {
  int[] buffer = new int[n];
  int[] count = new int[10];
  int i = 0;

  // exp의 자릿수에 해당하는 count 증가
  for (i = 0; i < n; i++) {
    count[(arr[i] / exp) % 10]++;
  }

  // 누적합 구하기
  for (i = 1; i < 10; i++) {
    count[i] += count[i - 1];
  }

  // 일반적인 Counting sort 과정
  for (i = n - 1; i >= 0; i--) {
    int idx = (arr[i] / exp) % 10;
    buffer[count[idx] - 1] = arr[i];
    count[idx]--;
  }

  for (i = 0; i < n; i++) {
    arr[i] = buffer[i];
  }
}
🪚 장점
- 문자열과 정수의 정렬이 가능하다.
- Stable sort
🪚 단점
- 자릿수가 없는 데이터에 대한 정렬은 불가능하다. (ex. 부동 소숫점)
- 중간 결과를 저장할 추가적인 메모리 공간이 필요하다.
| Time Complexity | Space Complexity |
|---|---|
🧷 계수 정렬 (Counting Sort)
말 그대로, 몇 개인지 개수를 세어 정렬하는 방식이다.
- 주어진 데이터 중 가장 큰 값을 size로 하는 배열을 생성한다.
- 배열을 탐색하며, 데이터의 등장 횟수를 해당 index에 저장한다.
- 이후 완성된 등장 횟수 배열을 누적합으로 변경한다.
-
주어진 데이터 배열을 뒤에서부터 탐색하며,
등장 횟수 배열[주어진 데이터 배열의 값]에 해당 숫자를 위치시킨다.- 그리고 누적합 배열의 값을 1씩 감소시킨다.


void countingSort(int[] numbers) {
  int[] sortedArr = new int[numbers.length];
  int[] counting = new int[Arrays.stream(numbers).max().getAsInt() + 1];

  // 등장 횟수 계산
  for (int num : numbers)
    counting[num]++;

  // 누적합 계산
  for (int i = 1; i < counting.length; i++)
    counting[i] += counting[i - 1];

  // 누적합 배열과 주어진 데이터를 이용해 정렬 수행
  for (int i = numbers.length - 1; i >= 0; i--) {
    sortedArr[counting[numbers[i]] - 1] = numbers[i];
    counting[numbers[i]]--;
  }

  System.out.println(Arrays.toString(sortedArr));
}
🪚 장점
- 최선의 경우 의 시간 복잡도를 가져, 가장 빠른 정렬 알고리즘이다.
- Stable sort
-
정렬할 데이터가 특정한 범위 안에 있는 경우 자주 사용한다.
- 대표적으로는 26개의 알파벳으로 이루어진 문자열에서
Suffix Array를 얻는 경우이다.
- 대표적으로는 26개의 알파벳으로 이루어진 문자열에서
🪚 단점
-
데이터의 최댓값에 해당하는 만큼의 추가적인 메모리 공간이 필요하기에(누적합 배열에 접근하는 시간을 로 하기 위해) 대부분의 경우 엄청난 메모리 낭비를 야기할 수 있다.
- 만약 주어진 데이터의 값 범위가 너무 큰 경우, 사용하지 않는 메모리 공간의 낭비도 발생하게 된다.
| Time Complexity | Space Complexity |
|---|---|